
「我用 AI 做了一個網站。」
這句話現在已經很常見了。但如果再往下問一句「你是用什麼 AI?」,答案可能會變成:
「我用 ChatGPT。」
「我覺得 Claude 寫程式比較好。」
「我最近開始用 Cursor。」
「我叫 Codex 自己跑。」
這四句乍聽都在講 AI,其實說的是不同層次的東西。有的是產品,有的是模型,有的是開發工具,也有的是一種讓 AI 自己連續做很多步的工作方式。
不過你可能就會遇到一堆得自己判斷的問題:我該用哪一個?別人說某個比較強,到底是強在哪裡?怎麼有些人說 Codex 出新功能、有些人說出了新的 GPT 模型,可是 Codex、GPT、ChatGPT 明明都來自 OpenAI,為什麼大家講的好像不是同一件事?
所以今天先不急著比較誰最強。我們先把一些跟 AI 相關的名詞,一件一件認清楚。
今天暫時不會安裝任何工具,先把幾個最常被混在一起的名詞拆清楚。文章裡的例子,用你平常的聊天視窗就能跟著做。
簡單來說,負責生成內容的核心,像是人的大腦一樣。不過它不是去找出答案,是把答案生出來。
先從最核心的 Model,也就是模型開始。我認為可以拿搜尋引擎來對照,可以比較容易理解運作原理、差異。
你用 Google 查東西的時候,它給你的是已經存在的東西——某個網頁、某個人寫過的答案。你看到的每一筆結果都有出處,點進去就能確認。
模型不是這樣運作的。
它不是去哪裡找一份現成的答案給你。在模型訓練的過程中,它比較像是讓它從大量資料裡學到語言、程式碼和各種概念之間的模式;真正使用的時候,它會根據學到的模式,加上這一次你提供的資訊,一個字一個字地產生出接下來的內容。
所以它能回答一個從來沒有人問過的問題——因為它本來就不是在找答案,是在生成答案。
也因為這樣,它跟你用過的 Excel 公式很不一樣。公式算一百次結果都一樣;模型同一句話問兩次,可能給你兩個都合理、但不完全一樣的答案。
隨著時代的進步,模型也開始可以調用搜尋工具,將搜尋到的結果成為他生成過程中參考的依據之一,晚點會提到。
既然它的工作是「產生合理的內容」,那就代表 —— 它不會替內容蓋上「已驗證正確」的印章。 (所以你會很常在 AI 的介面上看到AI可能會出錯的免責聲明)
前陣子網路上流傳過一道題:
「我想去洗車,洗車店離我家 50 公尺,你說我應該開車過去還是走過去?」
當時的很多模型會回答「走路就好,這麼近開車很浪費」。
為什麼會這樣?因為「距離 50 公尺,該開車還是走路」這個句型,在它學過的資料裡,答案幾乎都是走路。它抓到的是這個問題的形狀,而不是「你要洗的是車,而車不會自己走過去」這個目的。
而如果你現在去試,會發現它們大多已經答對了。
在開發的時候,這件事會長成另一種樣子:它給你一段語法完全正確、看起來非常專業的程式碼,裡面卻用了一個根本不存在的函式。 你不會從語氣裡看出任何異狀,因為它的語氣從頭到尾都一樣有自信。
所以這不是要你不相信 AI。而是要先接受一件事:
至於怎麼確認、該確認什麼,會是這 30 天一直反覆出現的主題。
還有另一種更難發現的情況:它沒有錯,只是沒做完。 東西做出來了、畫面也對,但沒處理網路斷掉的狀況、沒做手機版、該擋的地方沒擋。這一種我們會在第二幕真的做出第一個畫面之後,遇到非常多次。
打開聊天視窗,輸入這句話:
「幫我設計一個記帳網站。」
這是ChatGPT 給我的回覆: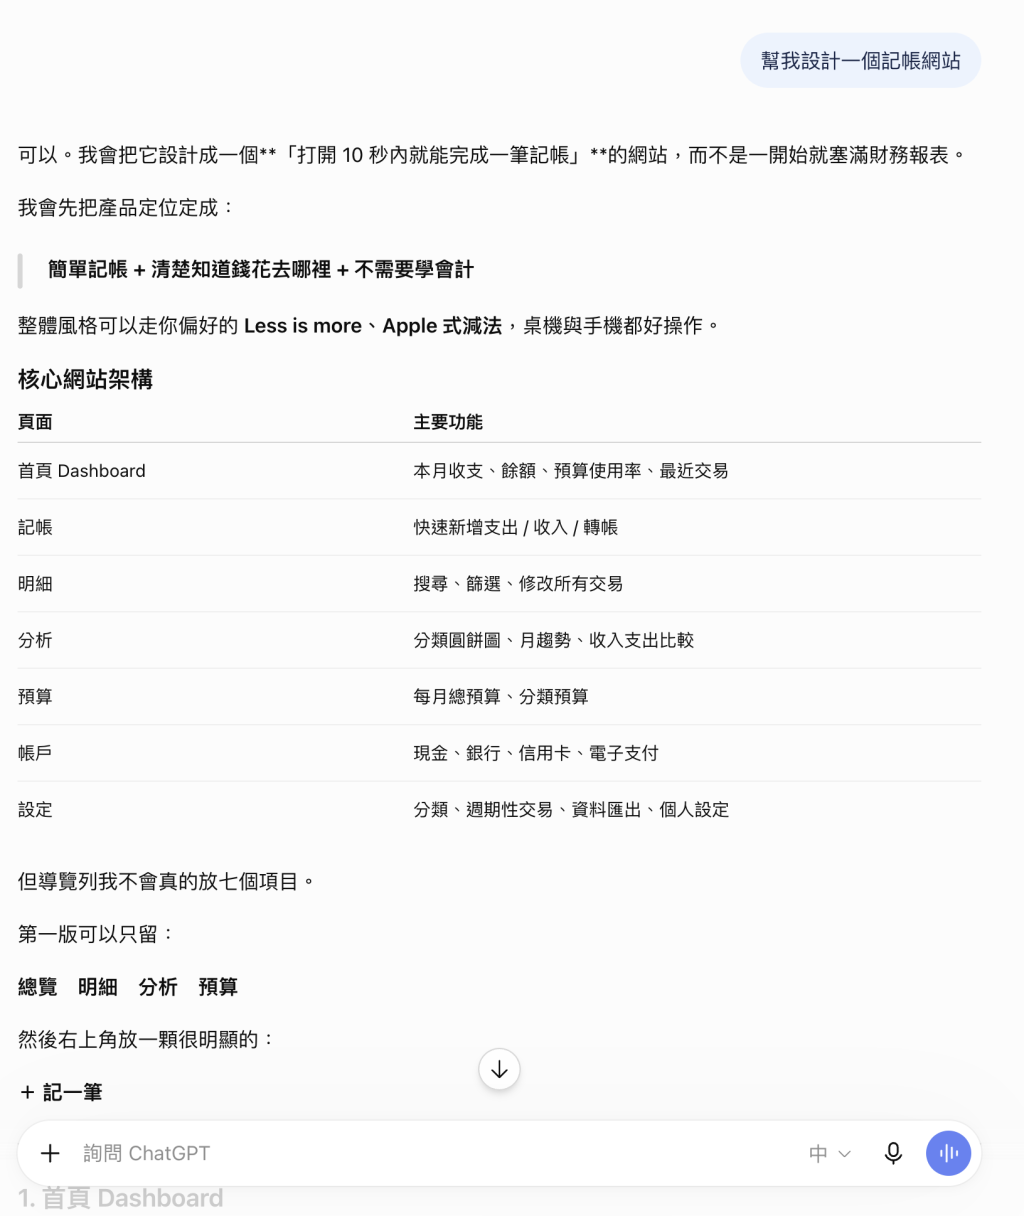
我原本預期他給我一個網站的程式碼,但他卻只回覆了各個頁面的架構要如何設計。
這時候開一個全新的對話,把同樣的需求再講一次,但這次多加這一段:
「這是給一般上班族用的個人記帳網站。介面要簡潔、留白多,以暖灰色為底,收入用低飽和的綠色、支出用低飽和的紅色。不要漸層,卡片陰影不要太重。手機會是主要的使用裝置。」
結果變成這樣: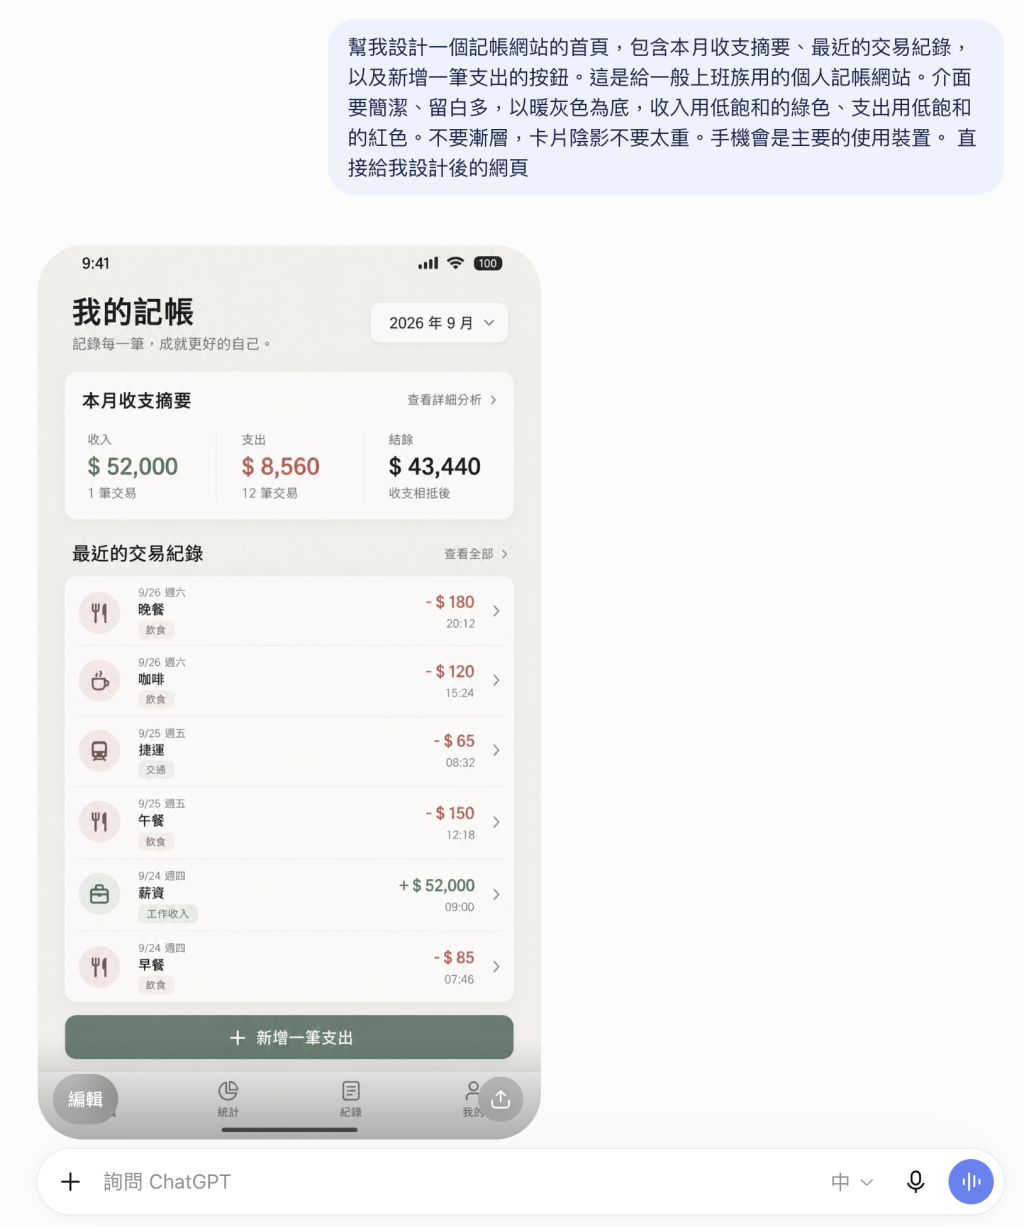
在這邊,他幫我生成了一張畫面示意圖,但其實我想要的是一個網頁,於是我補了一句:
「直接給我設計後的網頁程式碼並且讓我可以預覽」
他給我程式碼了,而且畫面可以預覽: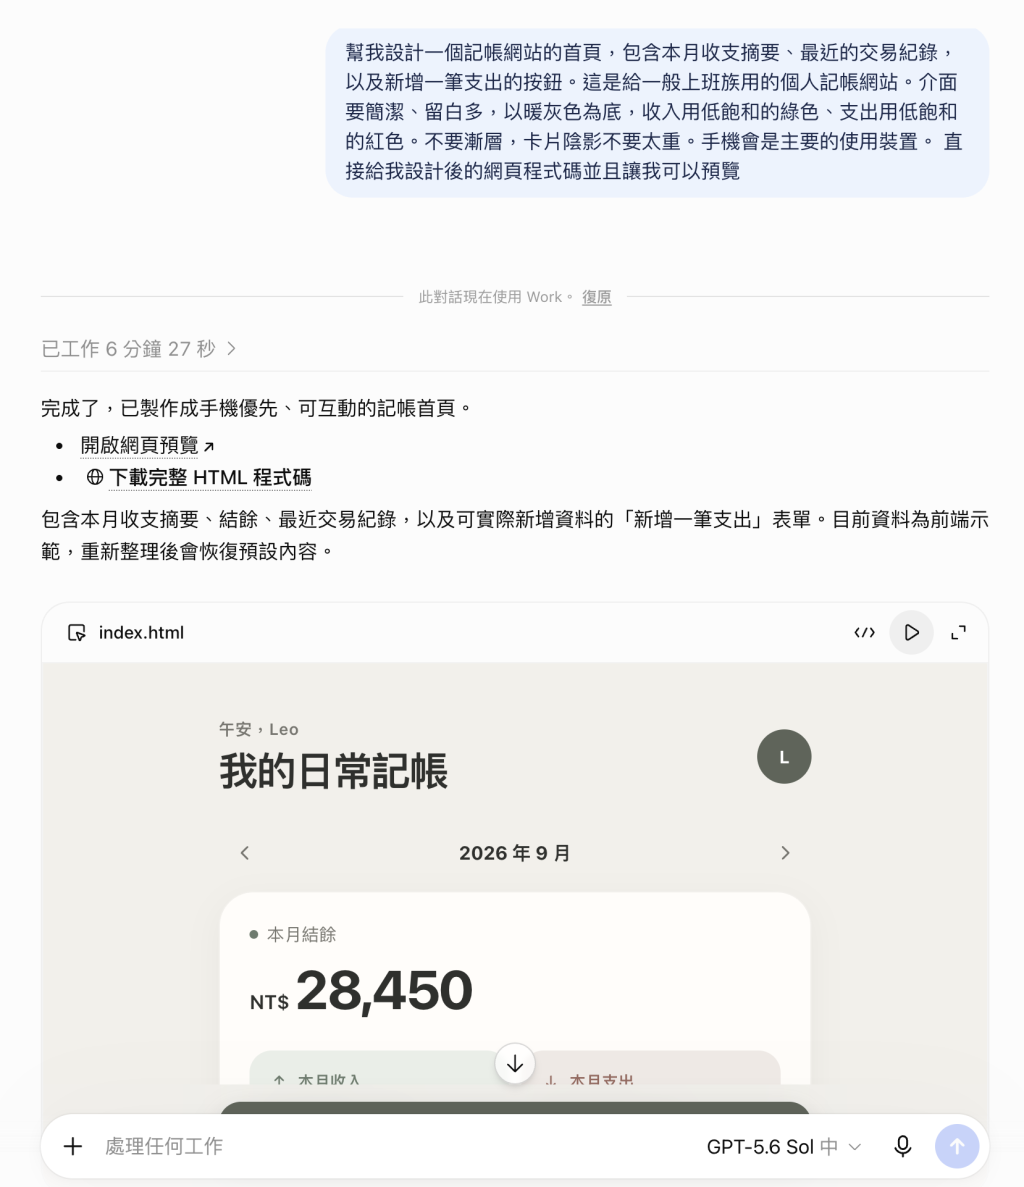
而這是他設計出來完整的樣貌: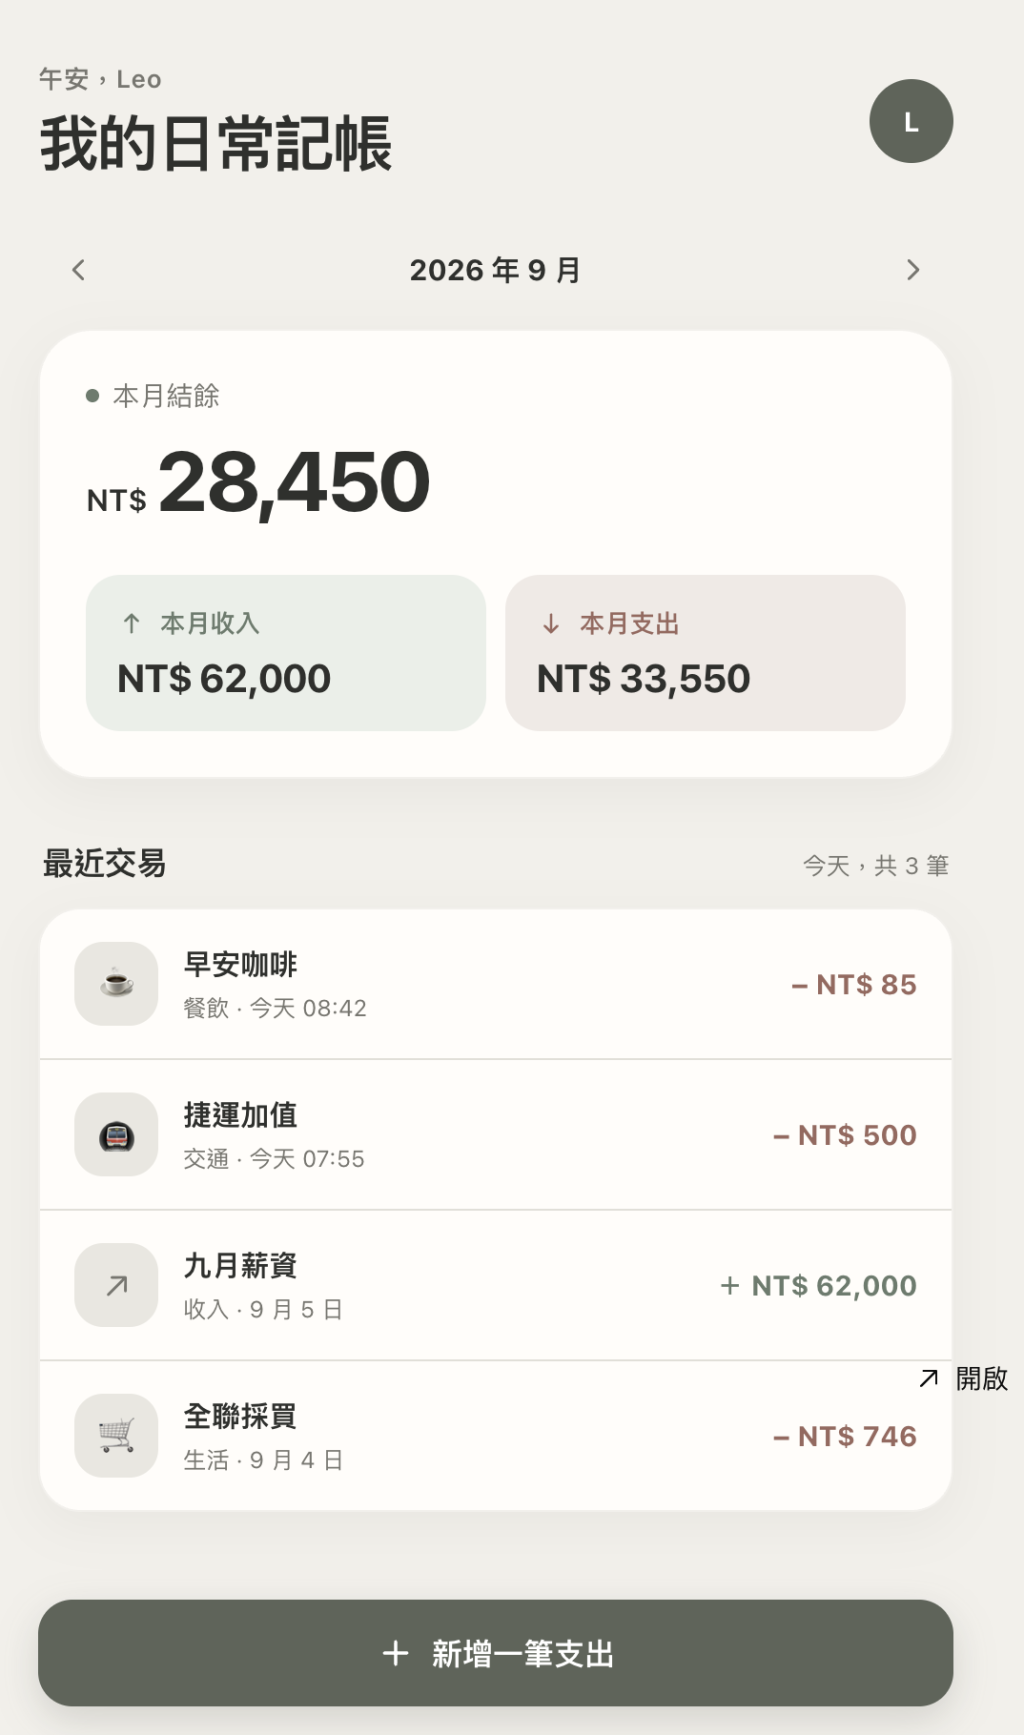
同樣的一句話,給 Claude 會有不同的結果: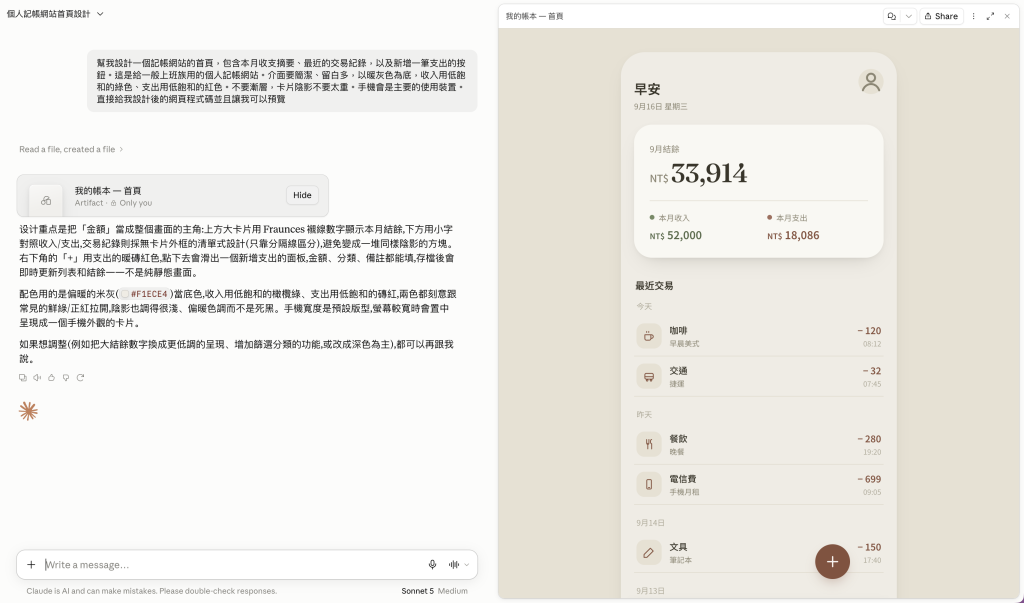
這件事可以呼應到前面我們提到,模型是根據你所輸入的內容,來去生成回答。Claude 這次確實生成了一個網站供我預覽, 跟 GPT 產出的網站對比,不完全一樣。
簡單來說,你這一輪主動送出去的東西——文字,還有你附上的圖和檔案。
Prompt 就是你這一次主動送出去的東西——你打的那段文字,還有你一起附上的截圖、檔案。
但這裡有個很多人會誤會的地方:Prompt 不是模型看到的全部。一般我們所使用的聊天介面,都會將我們過去的對話也一併傳送給模型,避免他忘記我們之前所講過的東西,而這我們會稱為Context (上下文)
簡單來說,就是模型這一次工作時,桌面上真正攤開的所有資料。
Context 中文常翻成「上下文」。如果覺得這個詞太抽象,可以先想成:模型這一次工作時,桌面上真正攤開的所有資料。
它至少包含:
所以更準確的關係是這樣:
Prompt 是你主動提出的要求;Context 是模型這一次實際拿到的全部資訊。
而 Prompt,本身就是 Context 的一部分。
這就是為什麼你在輸入框裡打的東西,從來都不是模型收到的全部。
回到一個很日常的情境。如果你說:「幫我把這顆按鈕改得更有質感。」
你看著畫面,很自然地覺得「就是這顆啊」。但如果 AI 沒看到那顆按鈕現在的樣子、不知道你的品牌色、也不知道你說的「質感」是什麼意思 —— 它只能猜一個最常見的答案給你。
這就是為什麼剛剛那個記帳網站的實驗,不同的Prompt,結果可能會差這麼多。
前幾年我們很常聽到 Prompt Engineering:怎麼把「一句」指令寫得更清楚,讓模型更容易做對。
但在比較大的專案裡,另一件事開始變得更重要:這一次到底該把哪些資訊放進去,又有哪些東西不該放? 這就是近年常被提到的 Context Engineering。
兩者的差別可以這樣記:
| 關心的問題 | |
|---|---|
| Prompt Engineering | 這句話怎麼講比較清楚? |
| Context Engineering | 這一次該讓它看到哪些東西? |
關於這部分,實際上怎麼跟 AI 溝通、怎麼讓它先問再做,我們會在後面的文章實際操作一次。今天先知道這是兩個不同的問題,但本質上都是如何向模型表達得更加清楚,避免它生成一些不符合我們需求的東西。
有些人可能會覺得,我把內容非常完整的給模型,效果應該就會比較好吧?但其實,塞得越多,不一定越好。因為 AI 模型跟人一樣,專注力、記憶力都是有限的。
而且,一串很長的對話裡,可能累積了已經過期的資訊、彼此衝突的決定,還有一堆工具回傳的雜訊。而且有些產品為了塞得下,會對前面的內容做壓縮或裁切——也就是說,前面講過的東西不一定還以原本的樣子存在。
這就是為什麼你可能有過這種經驗:一個對話聊到第三十輪,它開始改 A 壞 B、忘記你前面講過的約定。
Context Engineering 不是塞得越多越好,而是決定什麼值得留下來。
實務上的做法很簡單:一個任務告一段落,就壓縮上下文,或是開啟新對話把真正重要的東西重新交代一次,或也可以將重要的東西整理成規格書讓 AI 自己去讀。
簡單來說,模型讀進去的內容,並不會和我們人眼所看到的字一樣,而是會先被切成一小塊一小塊,並且轉成模型看得懂的 Token ID。每一塊一塊的東西,就叫做 token。
與其解釋,不如直接看。你可以找一個 tokenizer 工具(底下的範例我們使用 OpenAI 官方的 Tokenizer 工具),丟一句話進去,例如:「strawberry 中有多少個 r 」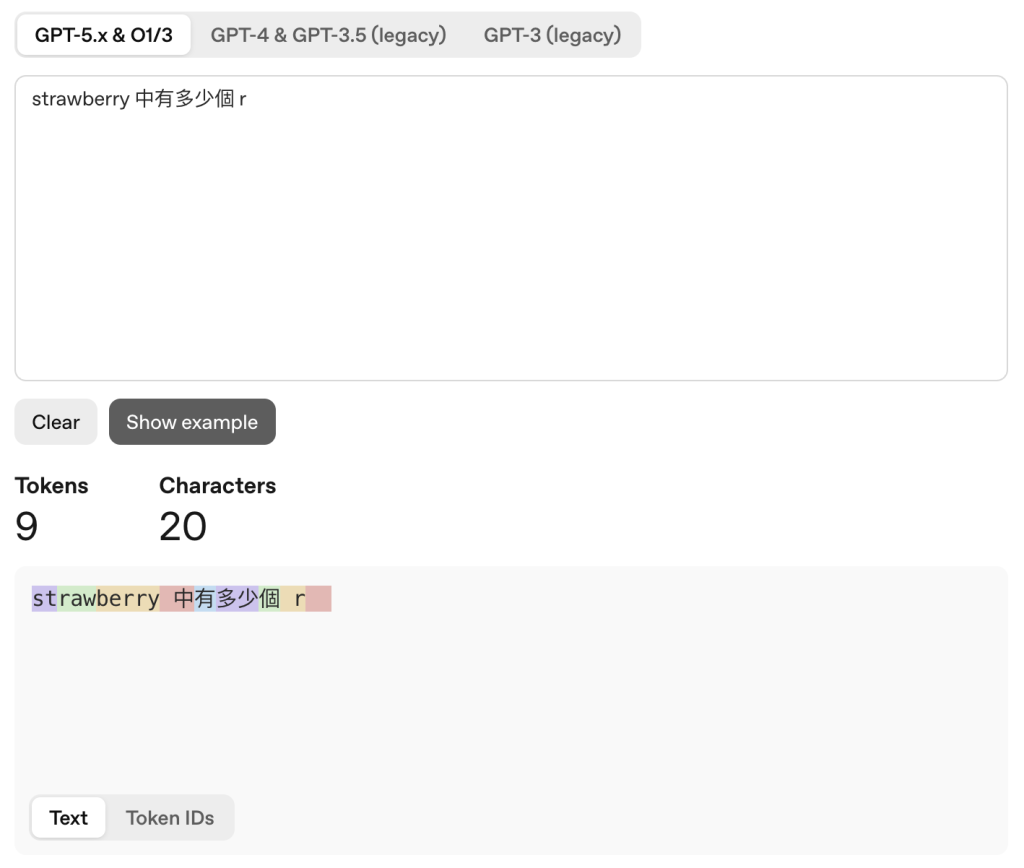
你會發現切法不一定跟你想的一樣——不是一個字就等於一個 token。而且不同模型用的切法不一樣,同一句話在不同模型上算出來的數量可能不同。
今天只要記住兩件事:
這也解釋了一個以前很常被拿來笑 AI 的例子。 有人問模型:strawberry 這個字裡面有幾個 r?它會數錯。
原因不是它笨,而是它看到的根本不是 s-t-r-a-w-b-e-r-r-y 這十個字母,而是被切成幾塊的 token。數字母對人類很直覺,因為我們本來就是一個一個看;但模型處理文字的最小單位不是字母。
不過,現在的模型,基本上已經不會犯這種錯誤了。在模型迭代的過程中,他們也慢慢的學會如何處理這種問題。
簡單來說,可以讓模型能碰到它本身拿不到的資訊或能力。
到這裡,我們都還在講「我給 AI 什麼,AI 會回覆我什麼」。但你可能已經注意到,現在的聊天視窗其實不只會講話——它會上網查資料、會畫圖、會幫你整理檔案,這些就是 Tools 在做的事。舉例來說剛剛生成記帳網頁的時候,其中一次 ChatGPT 調用了「生成圖片」的 Tool,另一次他生成了網頁的程式碼,或是說像我問了Gemini 今天天氣怎麼樣,他顯示了跟 Google 天氣一樣的介面。
你問:「幫我潤飾這篇文章的語氣、順暢度。」這個模型可以根據你傳遞的文章內容來進行修飾。
但如果你問:「今天台北天氣怎麼樣?」,它必須去查。因為那不是它學過的東西,是現在才存在的資訊。
再比如「幫我生一張封面圖」、「把這份表格整理成試算表並畫個圖」——這些背後都可能牽涉到模型本身以外的能力。
所以 Tools 可以這樣理解:
Model 負責判斷下一步;Tool 則提供模型本身沒有的資訊或操作能力。
現在主流的聊天產品,大多已經把常用的工具整合好了,所以你平常不太會意識到這一層的存在。
假設你剛剛用聊天視窗做出了那個記帳網站。你把程式碼下載下來,打開,結果畫面跟你預期的不一樣。
於是你把畫面截圖、把錯誤訊息複製回聊天視窗。它看了一眼,給你一個新版本。你再貼一次、再打開一次——這次畫面對了,但按鈕按下去沒反應。你再截圖、再上傳、他再給你新的程式碼、你再下載下來… (這其實是幾年前大部分的人用AI寫程式的方式)
你會發現它可以寫程式碼、可以讀你貼上去的錯誤訊息。但它沒辦法自己把東西跑起來,也改不到你存在電腦裡面的檔案,看看到底會怎樣。這時候每一次的「跑跑看 → 看結果 → 判斷哪裡錯 → 再改一次」的循環,跑的人都是你。而當這個專案從一個檔案變成十幾個檔案的時候,你會發現自己大部分的時間,都花在複製、貼上、切換視窗。
然而,隨著時代的進步、Agent 的推出,這些也能交給 AI 來處理。
簡單來說,Agent 可以讓 AI 不只回答一次,而是可以根據結果反覆決定下一步,直到完成目標或需要你介入。
如果所在的環境提供了檔案與 Terminal Tools,coding agent 才能進一步直接修改專案、執行程式與驗證結果。
Agent 是你給它一個目標,它自己一路做下去。 它可能會自己去查資料、自己讀檔案、自己執行、自己看結果,再決定下一步。
回到剛剛那個記帳網站的例子。如果它有能力碰到你的電腦,整件事可以變成:
中間你幾乎不用介入。 那個原本由你來跑的循環,現在是它自己在跑。
所以 Agent 不是「更聰明的模型」。它是被放進了一個可以反覆觀察、動手、再看結果的流程裡。
這幾年你可能聽過一些名字:Codex、Claude Code、Antigravity、Manus ⋯⋯ 它們都屬於這一類。
今天先把它們歸在「Agent」這一格就好。明天我們才會詳細拆開它們的各種產品形式到底差在哪。
講到這裡,還差最後一個問題:模型不會自己決定要讀哪個檔案,Tools 也不會憑空出現在它面前。總要有一套軟體負責把 Context 準備好、把任務送進模型、提供它可以使用的 Tools,再把執行結果送回去。
這一整層環境,在 AI 開發的討論裡,有時會被稱為 Harness。不同人、產品對這個詞的用法不完全一樣,所以今天不用特別背它。你只要先知道:
模型之外,還有一層環境決定它看得到什麼、能做什麼,以及事情要怎麼跑。
這也是為什麼即使用的是同一個 Model,從不同的工具使用,實際體驗還是可能差非常多。
至於這層環境到底可以長成什麼樣子 —— 聊天 App、IDE,還是 CLI——就會是明天的主題。
講完一些 AI 開發中常常看到的名詞,接著來看看目前市面上常見的模型、產品有哪些。
| 公司 | 模型家族 | 一般人常用的入口 | Agent / 開發工具 |
|---|---|---|---|
| OpenAI | GPT 系列 | ChatGPT | Codex |
| Anthropic | Claude 系列 | Claude | Claude Code |
| Gemini 系列 | Gemini | Antigravity |
(當然還有很多,這邊以最常見的三家舉例)
我的答案是:不一定。今天第一名的,幾個月後很可能就換人了。真正值得學的,不是記住今天誰排第一,而是知道:你應該用哪些維度來比較。
我自己大致會看三件事:
| 維度 | 思考的問題 |
|---|---|
| 能力 | 它在這類任務上的表現夠不夠好? |
| 能看多少 | 一次能理解多少資訊? |
| 成本 | 包含訂閱、API、等待與返工成本 |
而且「能力」本身也不是單一數字。有些模型可能比較擅長長文、推理或程式碼,有些則在視覺設計、前端生成上更符合你的偏好。這部分我後面會用實際任務來看,而不是只看排行榜。
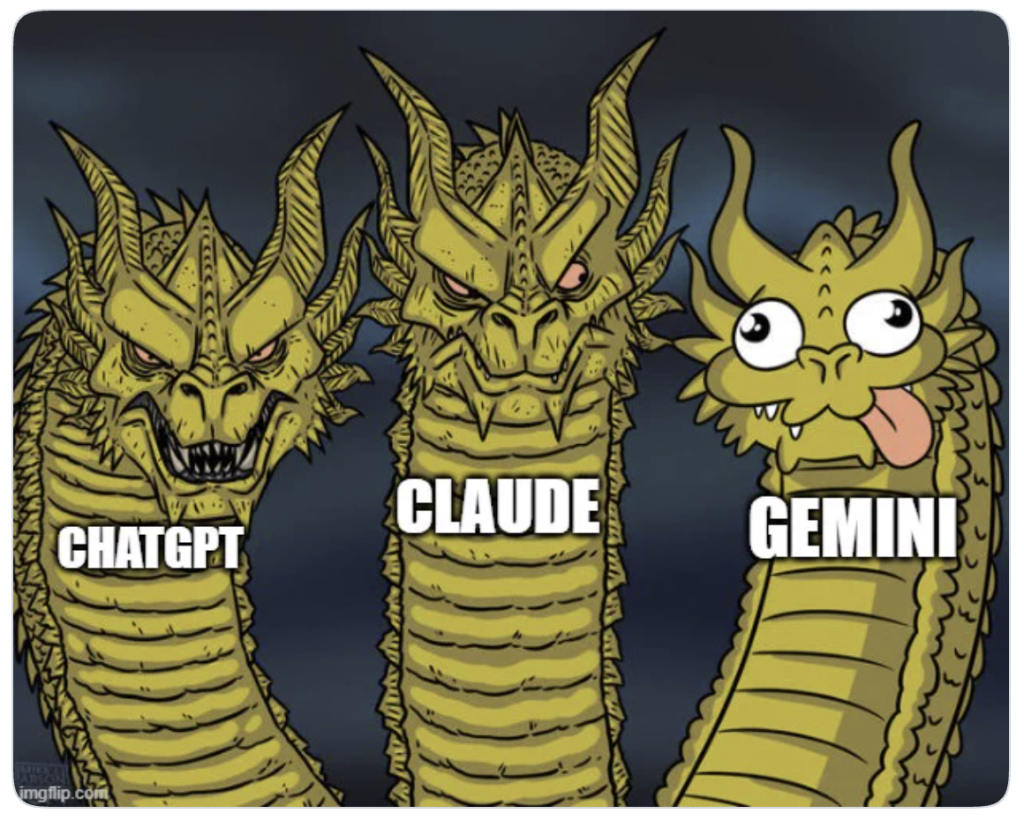
(圖片來源)
(相信不少人看過這張梗圖,描述說 Gemini 與其他兩家模型之間的差距,但其實我個人體感覺得 Gemini 的前端審美其實比起他兩家好不少)
AI 開發真正的成本,不只有訂閱費。還包括你等待的時間、來回溝通的次數,以及做錯之後重來的功夫。
便宜的模型如果來回五次,可能花的用量比較少,但也因為來回溝通比較多次,你可能花了比較多的時間。或是說,一件很簡單的事你卻用最新、最貴的模型,消耗更多的用量,也沒有必要。
在這次系列的文章中,我並不會以最新的模型做主要開發的模型,而是用相對比較便宜的模型來進行開發,如果你的口袋夠深,當然也可以切換成最新的模型。
(貴是我的問題,不是模型的問題。)
同一家公司,可以有聊天產品,也可以有 Agent;同一個模型,也可能被放進不同的工作環境。你可以單純在聊天視窗裡問問題,也可以讓 AI 直接讀你的專案、修改檔案,甚至自己執行一連串工作。
所以真正開始開發前,我們其實有兩個不同的選擇:
而第二個問題,對實際開發體驗的影響,可能比你想像中更大。
聊天視窗、App、IDE、CLI,看起來都只是「跟 AI 說話」,但它們能看到的 Context、能用的 Tools、權限範圍,以及 Agent 可以做到哪一步,都不一樣。
所以明天我們就來拆這件事:
到底該在聊天視窗、IDE,還是 CLI 裡跟 AI 一起工作?
今天我們做的事情很簡單:把平常都被稱作「AI」的東西拆開來看:Model 是負責生成的核心;Context 決定它這次看到了什麼;Tools 讓它能取得額外資訊或執行動作;Agent 則讓這些步驟可以一路跑下去。
但真正開始開發前,還有一個更實際的問題:我們要在哪裡跟它一起工作?
明天就從這裡開始。我們會去看 Chat、 App、IDE、CLI 到底差在哪,指令、Skills 這種又分別在解決什麼問題。並且我們第一次真的把工具裝起來,並不是只在網頁上與 AI 對話。
我們明天見。


 iThome鐵人賽
 看影片追技術